現行方式(既定・CPU)β
90分以内・人数は自動/指定。初回約58MB。長い音声は数時間かかる場合があります。
その声を、
読み返せる言葉に。
音声・動画をPCの中で文字起こし。
原文と時刻を残して、確認・編集できます。
無料・登録不要・ブラウザで利用
ページ表示と初回モデル取得には通信が必要です。
ローカルで完結。サーバーへのアップロードは不要。
音声・動画ファイルも作業内容も、お使いのPC内で処理します。
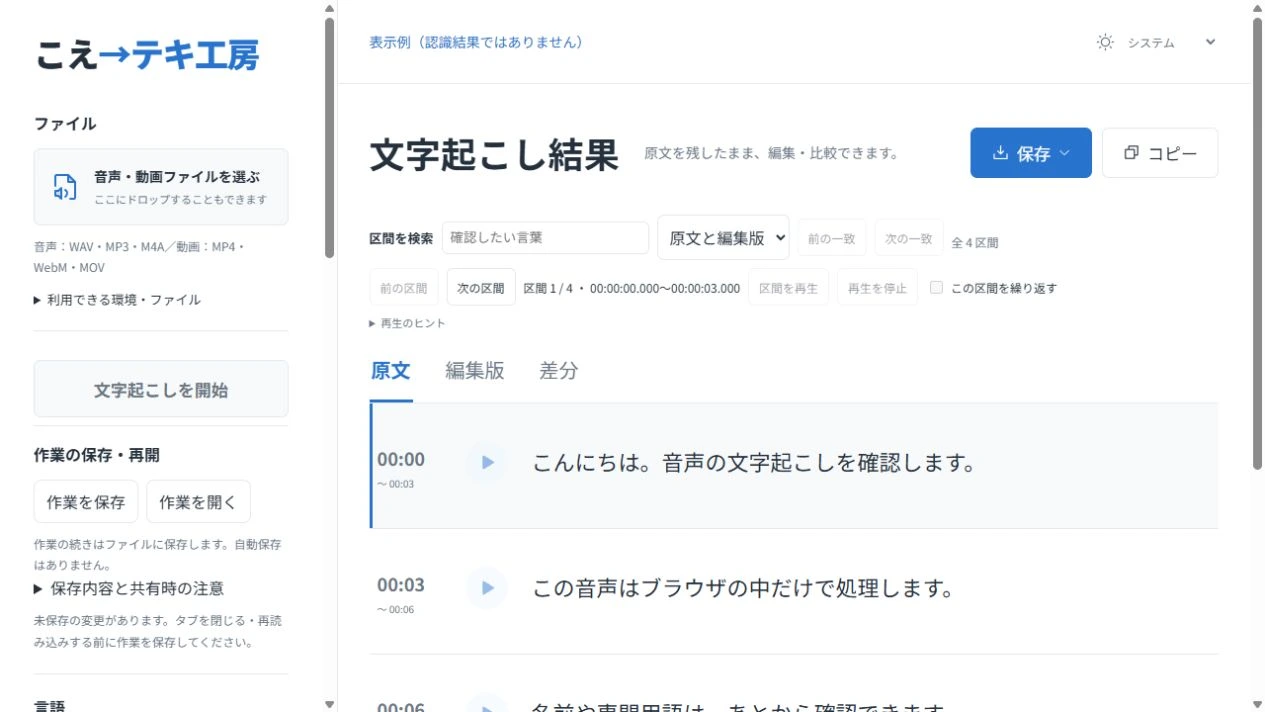
音声・動画を選び、対応PCでは「高精度」で認識します。初回は容量・メモリ負荷を確認し、同意してからモデルを取得します。
音声と照合し、残った誤りを手動や辞書で修正。AI訂正案は必要な区間だけ使えます。原文と時刻は残ります。
本文や字幕を書き出せます。編集や話者名は作業ファイルへ保存。再生するときは元の音声を開き直します。
音声:WAV・MP3・M4A
動画:MP4・MOV・WebM
音声の種類やブラウザにより、読めない場合があります。
TXT・SRT・VTT
作業ファイル(.koe-teki.json)
原文・時刻・編集・候補・話者を保存。音声は含みません。
「高精度」はWhisper large-v3-turbo。音声と照合し、残った誤りを手動や辞書で直します。
初回約1.64GB、追加の空き約4GBが目安。WebGPU・shader-f16対応GPUと十分なメモリが必要です。精度の向上や動作は保証しません。
手動や辞書で直しにくい区間をGemma 4 E2Bで確認。必要なければ、取得せずに作業を終えられます。
別途初回約3.2GBの取得・空き容量は約5GBが目安。対応GPUと十分なメモリが必要です。
自動保存はありません。閉じる前に作業を保存してください。
PC向けのツールです。Windows版Chrome・Edgeで基本操作を確認しています。Mac・スマホ・タブレットの実機での動作は未確認です。
認識結果・訂正候補・話者の判定は音声と照合してください。録音・要約・翻訳・動画への字幕焼き込みは行いません。モデル取得後は開いているページ内で通信なしで処理できます。ページの再表示や未取得モデルの準備には通信が必要です。
使用ライブラリ・モデルの告知各区間に話者を付け、「話者A」を「田中さん」などに変更できます。同じ人の統合・解除や、話者名付きの保存・出力にも対応します。
自動判定は任意です。使う方式だけを同意して取得します。判定は音声と照合してください。既存の名前や手動割当がある作業では、結果を確認してから反映します。
Macでの動作は未確認です。確認済みの環境はWindows版Chrome・Edgeです。Macで使えた方は、機種・macOS・ブラウザ名とバージョンを、お問い合わせからお知らせいただけると助かります。
動作のご報告・お問い合わせWAV・MP3・M4Aの音声と、MP4・MOV・WebMの動画を読み込めます。動画は音声部分だけを文字起こしします。ファイル内の音声の種類やブラウザによって、読み込めない場合があります。
できます。「作業を保存」で作業ファイル(.koe-teki.json)に保存し、再開時に開いてください。本文の編集・保存は音声なしでも続けられ、再生するときに元の音声を開き直します。音声は作業ファイルに含まれません。TXT・SRT・VTTの出力もできます。自動保存はありません。
アップロードされません。読み込んだファイルや作業内容は、お使いのPCのブラウザ内で処理します。ページ表示とモデル取得には通信が必要です。この案内ページではアクセス解析・広告の表示や効果測定にも通信を利用します。
必要なモデルを取得した後は、アプリを開いたまま通信なしで文字起こし・編集・保存ができます。ページの再表示や未取得モデルの準備には通信が必要です。ブラウザの保存データを削除すると、モデルの再取得が必要になります。
はい。使うモデルだけで利用でき、すべて揃える必要はありません。初回は対応GPUのあるPCで「高精度」を選びますが、取得には同意が必要です。高精度は約1.64GBと大きなメモリを使います。非対応のPCでは「標準・軽量・最軽量」を選べます。保存済みの選択や作業ファイルの設定は維持します。
文字起こし後、手動や辞書で直しにくい区間にだけ使う補助機能です。各区間の「AI訂正案」を押すとGemma 4が本文を確認します。音声を再認識する機能ではありません。原文・時刻を残し、採用した候補だけを編集版へ反映します。誤った案や見逃しがある任意のβ機能で、使わずに作業を終えることもできます。
無料で使えます。会員登録も不要です。初回は、PCのブラウザに文字起こし用モデルをダウンロードしてから利用します。
できます。各区間へ手動で話者を付けるほか、任意の自動話者分離βも使えます。「話者A」を「田中さん」などに変更し、同じ人の統合・解除、作業の保存・再開、話者名付きTXT・SRT・VTT出力ができます。自動判定は誤る場合があるため、音声と照合してください。
既定の現行方式はCPUで動き、90分以内・人数の自動推定と指定に対応します。初回約58MBです。任意のNemotron 3 βはWebGPUが必要で、90秒以内・人数は自動のみ。初回約425MBと十分なメモリを使います。使う方式だけを同意して取得でき、切替だけで本文や既存の話者情報は変わりません。Nemotronの方が高精度とは保証していません。